ビジネスの意思決定やマーケティングにおいて、データに基づいた判断が完全に定着した現在でも、数字の表面的な解釈による重大なミスが後を絶ちません。その典型例が「相関係数」の誤読です。売上と広告費、Webサイトの滞在時間と成約率など、2つの要素がどれほど連動しているかを数値化する相関係数は、データ分析統計学基礎のなかでも最も身近で強力なツールの一つですが、その意味を正しく把握していなければ誤った経営判断を下す原因になりかねません。
「相関係数が高いから、この施策に予算を投じれば売上が伸びるはずだ」という短絡的な思考は、データの現場で最も警戒すべき罠です。この記事では、相関係数の根本的な意味や数値の目安、因果関係との決定的な違いからエクセルでの実践的な計算方法まで、実務で騙されないための必須知識を網羅的に解説します。
【基礎から整理】相関係数とは?2つのデータの直線的な関係性を暴く
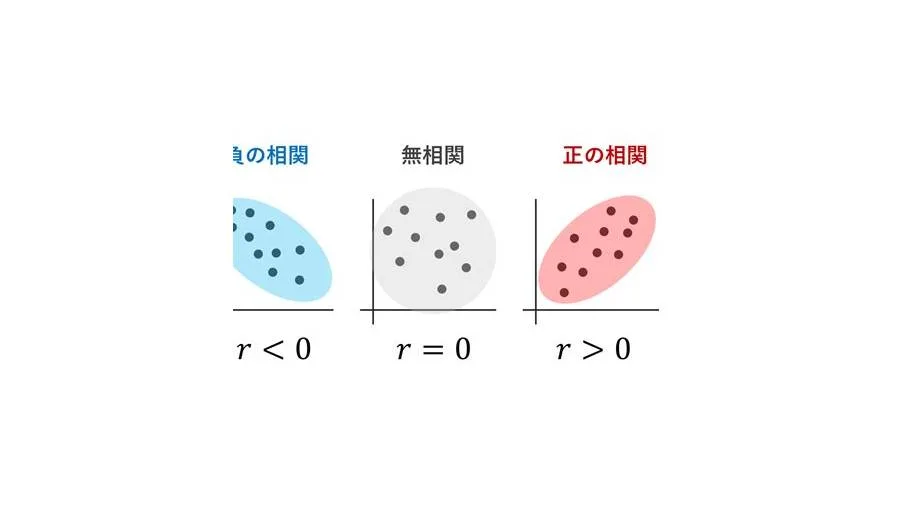
相関係数(Correlation Coefficient)とは、2種類の変数の間にある「直線的な関係性の強さ」を数値化した統計指標です。一般的にアルファベットの「r」(標本相関係数)やギリシャ文字の「ρ(ロー)」(母集団相関係数)で表され、数値は必ず-1.0から+1.0の間に収まります。
統計学で単に相関係数と呼ぶ場合、多くはイギリスの統計学者カール・ピアソンが考案した「ピアソンの積率相関係数」を指します。この指標が捉えるのは、あくまで「一方の数値が増加したとき、もう一方の数値がどれだけ直線を描くように増減するか」という点にあります。
相関係数の方向性は、大きく分けて以下の3パターンに分類されます。
- 正の相関(0 < r ≦ 1):一方のデータが増加すると、もう一方のデータも増加する傾向。「気温とアイスクリームの売上」「勉強時間とテストの点数」などが該当します。
- 負の相関(-1 ≦ r < 0):一方のデータが増加すると、もう一方は減少する傾向。「標高と気温」「商品の値上げ幅と販売数量」などが代表例です。
- 無相関(r ≒ 0):一方のデータの増減が、もう一方のデータの増減と直線的な関係を持たない状態。「個人の生年月日と年収」のように、互いに独立した関係です。
相関係数の求め方公式は、「2変数の共分散を、それぞれの標準偏差の積で割る」という構造になっています。各データの散らばり具合を標準化することで、単位(円、キログラム、パーセントなど)が異なるデータ同士であっても、同一のスケールで連動の度合いを客観比較できるのが最大の特徴です。
【数値の目安一覧】相関係数「0.7以上」の解釈と散布図の正しい読み方
実務の現場では、算出された相関係数が「どの程度であれば強いと言えるのか」という解釈基準が不可欠です。学術分野や業界によって多少の差異はあるものの、一般的な実務判断では以下の基準が広く用いられています。
| 相関係数の絶対値(|r|) | 相関の強さ | 散布図の形状と特徴 | 実務における評価・アクション指針 |
|---|---|---|---|
| 0.7 ~ 1.0 | 強い相関 | 点が右上がり/右下がりの直線上に細長く密集する | 連動性が極めて高い。施策立案の有力な候補となるが、因果の向きの検証が必須。 |
| 0.4 ~ 0.7未満 | 中程度の相関 | 緩やかな傾きを持った楕円状に点が分布する | 一定の連動性が認められる。ビジネスの現場では最も頻出する実用的な範囲。 |
| 0.2 ~ 0.4未満 | 弱い相関 | 広がりが大きく、わずかに方向性が伺える程度 | 単独での判断は危険。他の交絡因子やサンプルサイズを慎重に精査する必要がある。 |
| 0.0 ~ 0.2未満 | ほとんど相関なし(無相関) | 円形やランダムに散らばる、または明確な曲線を描く | 直線的な連動性は存在しない。非線形な関係性(U字型など)がないか確認を要する。 |
ここで極めて重要なのが、数値だけを見て満足せず、必ず散布図の読み方を身につけて実データをプロットすることです。有名な「アンスコムの例題」が示すように、相関係数が全く同じ「0.81」であっても、散布図を見ると「綺麗な直線」「極端な1点に引っ張られた分布」「綺麗な放物線(2次曲線)」など、全く異なる形状をしているケースが珍しくありません。相関係数はあくまで「直線関係」しか検知できないため、可視化を怠るとデータの真実を見誤ります。
なぜ多くの人が騙されるのか?「相関関係」と「因果関係」の決定的な違い
データ分析初心者はもちろん、ベテランのビジネスパーソンでさえ最も頻繁に陥るのが「因果関係との違い」の混同です。「AとBに強い相関がある」という事実は、決して「Aが原因でBという結果が生じた」ことを意味しません。
統計の世界で有名な古典的実例に、「アイスクリームの売上が増えると、水難事故の件数が増加する(正の相関)」というものがあります。この2つには強い相関が見られますが、「アイスクリームを食べたから溺れた(因果関係)」わけではありません。背後には「気温の上昇(猛暑)」という第3の共通要因(交絡因子)が存在し、気温が上がった結果としてアイスの消費が増え、同時に海や川へ行く人が増えて水難事故が増加しただけです。
このように、真の因果関係がないにもかかわらず、別の要因によってあたかも関係があるように見える現象を「疑似相関(Spurious Correlation)」と呼びます。
マーケティングの現場でも同様の誤認が日常的に起きています。例えば、「公式アプリのプッシュ通知を頻繁に開くユーザーは、月間購入額が高い(r = 0.75)」という分析結果が出たとします。これを「プッシュ通知を増やせば売上が上がる」と解釈して通知を乱発すると、ユーザーの離脱を招く悲劇が起こります。実際には「もともとそのブランドへのロイヤルティが高い顧客だから、通知も開くし商品も買う」という因果構造であることが多いからです。
因果関係を主張するためには、相関関係の存在に加えて、「時間の前後関係(原因が結果より先に起きている)」および「他の要因の排除(交絡因子のコントロール)」を実験や統計的手法で証明しなければなりません。
【実態検証】現場で頻発する3大ミス|外れ値の影響とスピアマンの順位相関係数
実際のビジネスデータやアンケート結果を分析する際、教科書通りの計算だけでは致命的なエラーを引き起こす要因が3つ存在します。現場で頻発するリスクの実態を検証します。
1. 外れ値の影響による「見かけ上の高相関」
ピアソンの積率相関係数は、外れ値の影響を極めて強く受けます。例えば、99件のデータが無相関(バラバラに分布)であっても、たった1件だけ「極端に大きなXとYの値」を持つ特異なデータ(億単位の超大口顧客など)が混ざると、相関係数が0.1から一気に0.85近くまで跳ね上がることがあります。現場では、データをクレンジングせずにエクセルへ投入し、この1点に騙されて誤った意思決定を下すトラブルが後を絶ちません。
2. データの性質に合わない相関係数の選択
一般的なピアソンの手法は、データが「間隔尺度・比例尺度」であり、かつ正規分布に近い線形関係を前提としています。しかし、顧客満足度調査の5段階評価(リッカート尺度)や、社内成績の順位といった「順序尺度」のデータを扱う場合は、ピアソンを適用すると歪みが生じます。
このようなケースでは、順位データ同士の関連性を測る「スピアマンの順位相関係数(またはケンドールの順位相関係数)」を使用するのが鉄則です。スピアマンの手法は外れ値に対しても頑健(ロバスト)であり、データが非線形であっても単調増加・単調減少の関係を適切に捉えることができます。
3. サンプルサイズ不足と「無相関の検定」の軽視
サンプル数がわずか5件や10件しかない場合、サイコロを適当に振ったような無関係なデータであっても、偶然高い相関係数が算出されてしまう確率が高くなります。そのため、得られた相関係数が「統計的に意味のある連動性なのか、それとも偶然の産物なのか」を判定する「無相関の検定(p値の算出)」を行わなければ、小規模サンプルのデータ分析は極めて危ういものになります。
【実践ガイド】エクセル関数「CORREL」で一瞬!相関係数の求め方と手順
実務で相関係数を求める際、手計算の公式を使う必要はありません。Microsoft Excelに標準搭載されている「相関係数エクセル関数」を活用すれば、数秒で算出が完了します。
エクセルでの基本操作手順
最もシンプルで実務上多用されるのが「CORREL(コレル)関数」です。
- 相関係数を表示させたいセルを選択します。
- 半角で「=CORREL(配列1, 配列2)」と入力します。
※「配列1」には1つ目のデータ範囲(例:A2:A100)、「配列2」には2つ目のデータ範囲(例:B2:B100)を指定します。 - Enterキーを押すと、-1から+1の間の数値が一瞬で出力されます。
なお、エクセルには全く同一の計算を行う「PEARSON関数」も存在しますが、計算アルゴリズムおよび戻り値は完全に同一であるため、文字数が短く標準的な「CORREL」を使用すれば問題ありません。
変数が3つ以上(例:売上、広告費、来店客数、平均気温など)ある場合、1組ずつCORREL関数を入力するのは非効率です。エクセルの「データ」タブ >「データ分析」>「相関」を選択し、全データ列を一括指定すれば、すべての要素の組み合わせを網羅した「相関行列(マトリックス表)」が一括生成されます。施策の優先順位付けを行う際、全体像を鳥瞰するための基本テクニックです。
【プロの結論】認知バイアスに惑わされないデータ分析の判断基準
人間には、「自分の信じたい仮説を補強するデータばかりに目を向け、都合の悪い事実を無視してしまう」という確証バイアスが本能的に備わっています。「このマーケティング施策は効果があるはずだ」と思い込んでいる分析者は、相関係数が0.6と出ただけで「ほら見ろ、強い関係がある!」と飛びつき、因果の逆転や交絡因子の存在を検証しようとしません。
データ社会において、数字を武器にする人と数字に踊らされる人の差は、まさにこの「健全な疑い」を持てるかどうかにあります。分析結果を施策や経営判断に落とし込む際は、以下の明確な基準で自己点検を行ってください。
相関分析の活用に向いているケース
- 探索的な仮説出しの段階:数百ある変数の中から、関連がありそうな「アタリ」を初期段階で効率よく絞り込みたい場合。
- 予測モデルの変数選定:機械学習や重回帰分析において、目的変数と連動する特徴量をスクリーニングしたい場合。
- 散布図で線形関係と外れ値の不在が目視確認できている場合:前提条件が整っており、純粋な直線関係を数値で共有したい場合。
相関分析の適用に極めて慎重になるべきケース
- 大規模な投資・予算配分を決定する局面:A/Bテストやランダム化比較実験(RCT)、差の差分析(DID)などによる因果推論を挟最初に、相関だけで投資を決めるのは極めて危険です。
- データが順位やアンケートの評点である場合:ピアソンではなく、スピアマン等のノンパラメトリック手法を選択する必要があります。
- 時系列データをそのまま比較する場合:年々増加傾向にある2つのデータ(例:日本の高齢化率とスマートフォンの普及率)は、全く無関係でも「見かけ上の強い相関」が出現するため、階差(前年比増減)を取るなどの前処理が必須です。
【相関係数とは】に関するよくある質問(FAQ)
Q1:相関係数が「0」に近い場合、2つのデータには完全に関係がないと断言できますか?
A1:いいえ、断言できません。相関係数が検知できるのはあくまで「直線的な関係」のみです。例えば、心理学の「逆U字曲線(適度な緊張が最もパフォーマンスを高め、無緊張や過度の緊張では低下する)」のような放物線を描くデータは、極めて密接な関係があるにもかかわらず、相関係数を計算すると「0」になります。必ず散布図を作成して形状を確認してください。
Q2:相関係数が「0.7以上」あれば、因果関係があると見なして施策を進めてよいですか?
A2:絶対に避けてください。相関係数が0.99であっても、それは「連動して動いている」ことしか示しておらず、疑似相関や因果の逆転(結果だと思っていたものが実は原因だった)の可能性が常に残ります。施策の実行には、論理的なメカニズムの裏付けや、一部のユーザーを対象とした小規模なパイロットテスト(介入実験)による因果検証が不可欠です。
Q3:ピアソンとスピアマンの相関係数はどう使い分ければいいですか?
A3:データが「テストの点数、売上金額、温度」のように連続した測定値で、正規分布に近く直線関係を調べたいときは「ピアソンの積率相関係数」を使います。一方、「顧客の満足度ランク(5段階)、検索順位、売上ランキング」のような順位データである場合や、外れ値が多く正規分布から大きく外れている場合は「スピアマンの順位相関係数」を使用するのが適切です。
まとめ:数字の罠を見抜き、意思決定を研ぎ澄ますために
相関係数は、膨大で複雑なデータ群から隠れたパターンを素早く発見するための優れたツールです。エクセルのCORREL関数を使えば誰でも一瞬で数値を導き出せる手軽さがあるからこそ、その背景にある統計的限界とバイアスのリスクを深く理解しておくことが大切です。
「数値を鵜呑みにせず散布図を見る」「相関と因果を厳格に区別する」「第3の要因(疑似相関)を常に疑う」という3つの原則を徹底すること。これこそが、データの嘘に騙されず、ビジネスや研究の現場で真に価値のある意思決定を下すための最大の武器となります。